
Server-Side Tracking: Technischer Leitfaden für mehr Datenqualität und Compliance
Server-Side Tracking leitet Website-Events zuerst an eine von Ihnen kontrollierte Serverinstanz weiter, bevor diese Daten an Werbe- oder Analyseplattformen fließen. Dadurch gewinnen Sie Kontrolle über Datenqualität, Performance und Weitergabe, Consent bleibt aber in jedem Fall Pflicht. Relevante Referenzpunkte sind die EDPB-Leitlinien zur ePrivacy-Richtlinie und das serverseitige Tagging-Modell von Google Tag Manager.
Kurz gesagt:
- Die Einwilligung bleibt Pflicht, denn das Signal muss vom Browser über den Webcontainer zum Servercontainer gelangen; ein eigener Server ändert die rechtliche Bewertung nicht.
- Ein kontrollierter Vergleichstest zeigt eine um 88,3 Prozent geringere Übertragungsmenge von JavaScript und rund 29,5 Prozent kürzere Ladezeiten im Median; reale Ergebnisse können abweichen.
- Ein bloßer Proxy leitet Daten unverändert weiter; erst wenn der Servercontainer Ereignisse bündelt, filtert oder anreichert, kann ein Leistungsvorteil entstehen.
- Selbst gehostete Systeme bieten mehr Kontrolle, verlangen aber dauerhafte Betreuung; verwaltete Anbieter senken den technischen Aufwand, geben dafür einen Teil der Kontrolle ab.
- Der Umstieg lohnt sich besonders bei Verlusten von Abschlussdaten oder fehlender Zuordnung von Käufen; kleine Websites mit geringem Besuchsaufkommen kommen oft mit sauberer browserseitiger Erfassung aus.
Inhaltsverzeichnis
- Was ist Server-Side Tracking? Technische Abgrenzung zu Client-Side
- Vorteile von Server-Side Tracking
- Implementierungsvarianten: sGTM, Self-Host und Managed Provider
- Technische Implementierung: Schritt-für-Schritt und Test-Checkliste
- Datenschutz und Recht: EDPB, ePrivacy und praktische Compliance-Checks
- Performance, Kosten und Evidenz: Benchmarks und Kapazitätsplanung
- Use Cases und Entscheidungshilfe: Wann lohnt sich Server-Side Tracking?
- Xpert-Perspektive: Vorgehensweise bei Migrationsprojekten
- Angebot: Xpert Marketing als Partner für Assessment und Implementierung
- FAQ
- Quellen
Was ist Server-Side Tracking? Technische Abgrenzung zu Client-Side
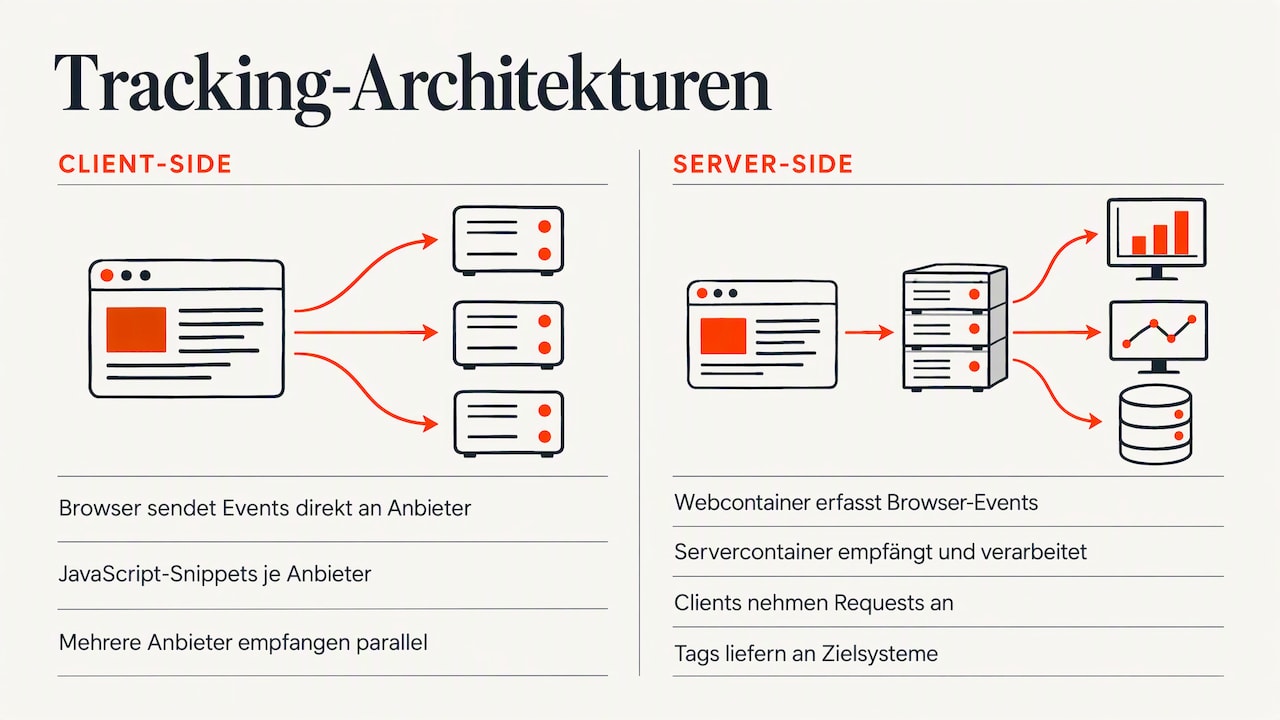
Beim klassischen Client-Side Tracking sendet der Browser Events direkt an Dutzende Drittanbieter-Server: Google, Meta, LinkedIn und weitere Werbeplattformen empfangen Daten parallel, jeweils über eigene JavaScript-Snippets. Server-Side Tracking schaltet eine Zwischenstation ein. Der Browser sendet Events nur noch an einen Servercontainer, den Sie selbst betreiben oder verwalten lassen, und dieser Container entscheidet, was an welchen Vendor weitergeht.
Google beschreibt das Modell mit zwei Containern: einem Webcontainer, der im Browser läuft und Events erfasst, und einem Servercontainer, der diese Events empfängt, verarbeitet und weiterleitet. Innerhalb des Servercontainers übernehmen Clients die Entgegennahme eingehender Requests, während Tags die Daten an Zielsysteme wie GA4, Meta Ads oder CRM-Systeme ausliefern.
Der Unterschied zwischen server-side tagging und server-side tracking ist dabei wichtig: Tagging beschreibt die technische Infrastruktur, also Container, Clients und Tags. Tracking beschreibt den eigentlichen Zweck, nämlich das Erfassen von Nutzerverhalten. Ein Servercontainer kann theoretisch auch ohne Personenbezug arbeiten, in der Praxis wird er aber fast immer für Tracking eingesetzt.
Der Browser übernimmt deutlich weniger Arbeit. Statt zehn oder fünfzehn Tracking-Skripte zu laden und auszuführen, sendet er ein einziges Event an den eigenen Server. Dort passiert dann das, was vorher im Browser verteilt ablief: Datenanreicherung, Filterung, Weiterleitung an mehrere Zielsysteme. Diese Verschiebung der Rechenlast ist der Kern dessen, was Server-Side Tracking von einer reinen Proxy-Lösung unterscheidet. Ein einfacher Proxy leitet nur durch, ohne die Daten zu verändern. Eine konsolidierte Architektur verarbeitet sie, bevor sie weiterziehen.
Vorteile von Server-Side Tracking
Der Umstieg lohnt sich aus mehreren Gründen, die sich gegenseitig verstärken.
Datenqualität und Zustellrate verbessern sich messbar, weil Events nicht mehr durch Ad-Blocker oder Browser-Tracking-Schutz wie Safaris ITP blockiert werden können, sobald sie über eine First-Party-Subdomain laufen. Die Performance profitiert gleichzeitig: Weniger JavaScript im Browser bedeutet schnellere Ladezeiten, und ein reproduzierbarer Benchmark von MetricFixer zeigt, dass konsolidierte serverseitige Flows den JavaScript-Transfer um 88,3 Prozent reduzieren können, bei einer medianen Verbesserung der Ladezeit von rund 29,5 Prozent gegenüber einem klassischen Web-GTM-Setup.
Die Kontrolle über personenbezogene Daten steigt, weil Sie vor der Weitergabe an Vendoren filtern, anreichern oder pseudonymisieren können, statt dass jeder Drittanbieter rohe Browserdaten erhält. Und die Angriffsfläche verkleinert sich, weil weniger externe Skripte im Browser laufen, die potenziell manipuliert werden könnten.
Die wichtigsten Vorteile im Überblick:
- Höhere Zustellrate an Analytics- und Ad-Plattformen durch First-Party-Kontext
- Spürbare Performance-Gewinne durch reduzierte Browser-Last
- Mehr Kontrolle über Datenanreicherung und PII-Filterung vor der Weitergabe
- Geringere Angriffsfläche durch weniger externe Skripte im Frontend
Diese Vorteile entfalten sich allerdings nur, wenn die Architektur tatsächlich konsolidiert, nicht nur durchgeleitet wird. Eine reine Proxy-Lösung ohne Verarbeitungslogik bringt kaum mehr als eine URL-Verschleierung.
Implementierungsvarianten: sGTM, Self-Host und Managed Provider
Für die technische Umsetzung gibt es im Wesentlichen drei Wege, und jeder bringt einen anderen Kompromiss zwischen Kontrolle und Aufwand mit sich.
Server-Side Google Tag Manager auf Google Cloud Platform lässt sich über eine automatische Provisionierung einrichten, die Google direkt anbietet. Das funktioniert gut für Testumgebungen und kleinere Projekte, stößt aber bei hohem Traffic an Grenzen, weil die Standardkonfiguration nicht für Produktionslasten mit starken Lastspitzen ausgelegt ist. Wer das selbst betreiben will, muss Skalierung, Logging und Patch-Management eigenständig verwalten.
- sGTM auf GCP: schnelle Einrichtung, aber Skalierungsgrenzen bei hoher Last ohne manuelles Tuning
- Self-Hosted: volle Kontrolle über Infrastruktur und Datenverarbeitung, dafür höherer Betriebsaufwand
- Managed Provider: geringerer technischer Overhead, da Hosting und Wartung ausgelagert werden
Self-Hosted-Varianten geben Ihnen die größte Kontrolle über Serverstandort, Datenverarbeitung und Compliance-Details, erfordern aber ein Team, das Infrastruktur, Monitoring und Sicherheitsupdates dauerhaft betreut. Managed Provider übernehmen genau diesen Teil, was den technischen Aufwand reduziert, allerdings bedeutet das auch, einen Teil der Kontrolle an den Anbieter abzugeben.
Unabhängig vom gewählten Weg braucht jede Implementierung ein durchdachtes Domain-Mapping: Der Servercontainer sollte über eine Subdomain der eigenen Hauptdomain erreichbar sein, etwa als tracking.ihredomain.de, damit Events im First-Party-Kontext ankommen. Google empfiehlt dieses Mapping ausdrücklich, weil es die Zustellrate deutlich erhöht und Cookies im First-Party-Kontext länger gültig bleiben lässt.
Technische Implementierung: Schritt-für-Schritt und Test-Checkliste
Die Umsetzung folgt einem klaren Ablauf, unabhängig davon, ob Sie sGTM, eine Self-Hosted-Lösung oder einen Managed Provider nutzen.
- Servercontainer einrichten und mit einer First-Party-Subdomain verbinden, damit Events nicht als Drittanbieter-Traffic erkannt werden
- Webcontainer im Frontend anpassen, sodass Events an die neue Server-URL statt direkt an Drittanbieter gesendet werden
- Consent-Signale aus dem Consent-Management-System technisch an den Webcontainer und von dort an den Servercontainer durchreichen
- Tags im Servercontainer konfigurieren, die Events an GA4, Werbeplattformen oder interne Systeme weiterleiten, gefiltert nach Consent-Status
- Preview-Modus nutzen, um einzelne Events end-to-end zu verfolgen, bevor sie live geschaltet werden
- Monitoring für Latenz, Fehlerraten und Event-Vollständigkeit aufsetzen, bevor der volle Traffic umgestellt wird
Der kritische Punkt in diesem Ablauf ist der Consent-Signalfluss. iubenda weist ausdrücklich darauf hin, dass Server-Side Tracking die Pflicht zur Einholung von Cookie- und Tracking-Zustimmung nicht aufhebt. Das Consent-Management-System muss sein Signal weiterhin im Browser erfassen und an den Webcontainer übergeben, der es dann an den Servercontainer weiterreicht. Nur mit diesem Signal kann der Server entscheiden, welche Events an welchen Vendor gehen dürfen.
Für die Testphase empfiehlt sich eine mehrstufige Routine: zunächst Einzelevents im Preview-Modus prüfen, dann End-to-End-Tests über den gesamten Trichter laufen lassen, und schließlich einen Replay-Test, bei dem reale Nutzerinteraktionen gegen die neue Architektur gespiegelt werden, um Abweichungen zu finden, bevor echte Kampagnendaten betroffen sind.
Profi-Tipp: Richten Sie ein Dashboard ein, das Event-Volumen zwischen Client-Side- und Server-Side-Pfad gegenüberstellt. Weicht die Zahl spürbar ab, deutet das auf einen Fehler in der Weiterleitung oder im Consent-Filter hin.
Nach dem Go-Live braucht die Architektur laufende Pflege: Logging der verarbeiteten Events, regelmäßige Prüfung der Datenschutzfilter, und eine Skalierungsstrategie für Traffic-Spitzen, etwa bei Kampagnenstarts oder saisonalen Peaks.
Datenschutz und Recht: EDPB, ePrivacy und praktische Compliance-Checks
Server-Side Tracking ändert nichts an der rechtlichen Grundlage, die für Tracking gilt. Die EDPB-Leitlinien zum technischen Anwendungsbereich von Art. 5(3) ePrivacy erläutern, dass die Vorschrift greift, sobald Informationen auf einem Endgerät gespeichert oder von dort ausgelesen werden, unabhängig davon, wo die Verarbeitung anschließend stattfindet. Die Guidelines definieren vier Kernelemente: Information, Terminalgerät, Zugriff und gespeicherte Information. Diese Kriterien gelten unabhängig davon, ob Daten direkt an einen Drittanbieter oder zunächst an einen eigenen Server fließen.
Das bedeutet konkret: Der Serverstandort oder die Tatsache, dass Sie den Server selbst betreiben, verändert nicht, ob Consent eingeholt werden muss. Entscheidend ist, ob das Endgerät des Nutzers instruiert wird, Informationen zu senden oder zu speichern. Genau das passiert bei den meisten Tracking-Implementierungen weiterhin, auch wenn der erste Empfänger jetzt Ihr eigener Server ist.
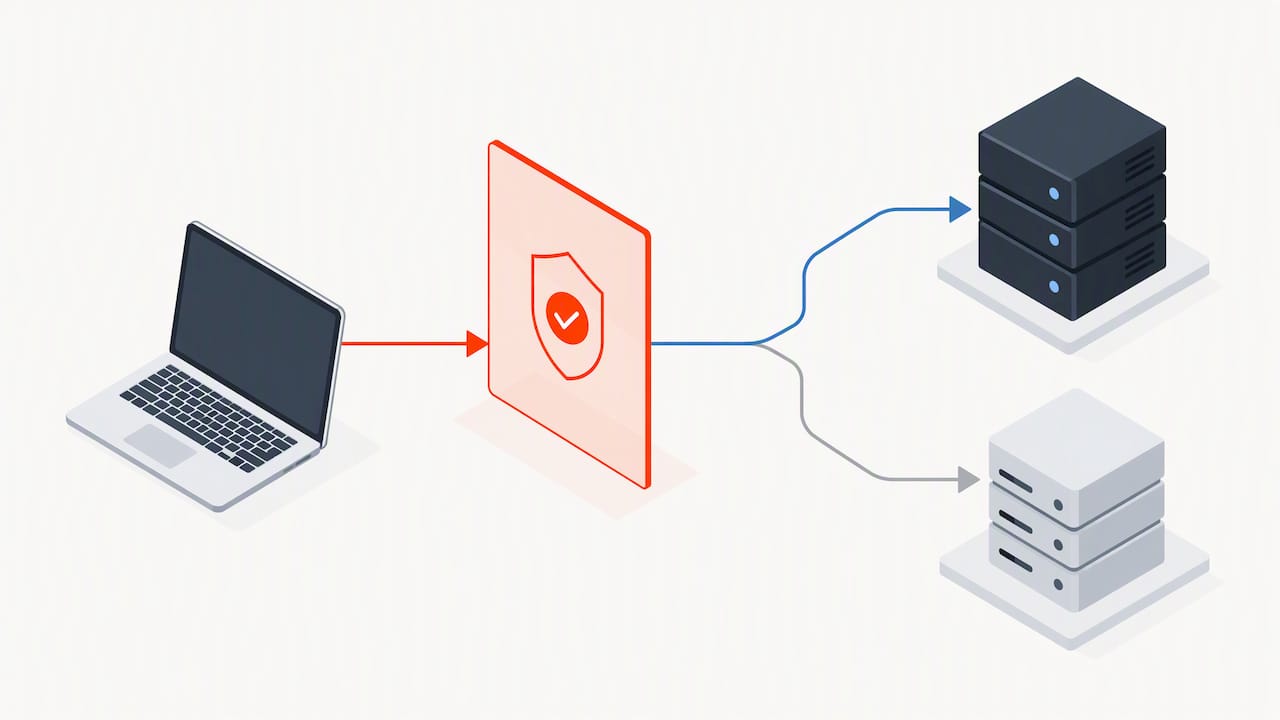
Die EDPB-Leitlinien benennen explizit mehrere Techniken, die unter Art. 5(3) fallen, darunter URL- und Pixel-basiertes Tracking sowie IP-basierte Methoden. Das zeigt, dass die rechtliche Bewertung technikneutral erfolgt, Server-Side Architektur schafft also keine automatische Ausnahme.
Praktisch bedeutet das für Ihre Umsetzung:
- Consent-Signale müssen technisch zuverlässig vom Browser zum Servercontainer durchgereicht werden
- Datenminimierung sollte im Servercontainer stattfinden, bevor Daten an Vendoren gehen
- Pseudonymisierung reduziert das Risiko, bevor Events externe Systeme erreichen
- Die Rechtsgrundlage für jede Verarbeitung sollte dokumentiert und nachvollziehbar protokolliert sein
Server-Side Tracking kann die Datenschutzlage sogar verbessern, weil Sie als Betreiber entscheiden, welche Felder überhaupt an Dritte weitergegeben werden, statt dass jeder Drittanbieter rohen Zugriff auf Browserdaten erhält. Das ersetzt die Einwilligung aber nicht, es ergänzt sie um eine technische Kontrollebene.
Performance, Kosten und Evidenz: Benchmarks und Kapazitätsplanung
Ein reproduzierbarer Benchmark von MetricFixer zeigt, dass konsolidierte serverseitige Flows den JavaScript-Transfer im Browser um 88,3 Prozent senken und die mediane Ladezeit um etwa 29,5 Prozent verbessern können, verglichen mit einem klassischen Web-GTM-Setup. Diese Werte stammen aus einem synthetischen, kontrollierten Testaufbau, das Repository dokumentiert Methodik, Rohdaten und Limitationen offen, Produktionsumgebungen können abweichen.
Der entscheidende architektonische Unterschied liegt zwischen einer reinen Proxy-Lösung und einer konsolidierten Architektur. Ein Proxy leitet Events unverändert weiter, er verschleiert lediglich den Ursprung. Eine konsolidierte Architektur verarbeitet, filtert und bündelt Events, bevor sie an mehrere Zielsysteme gehen, und genau diese Bündelung erzeugt den Performance-Gewinn im Benchmark.
Auf der Kostenseite stehen vor allem drei Posten: Cloud-Instanzen für den Servercontainer, Netzwerktraffic durch die zusätzliche Serverstation, und Redundanz, wenn Ausfallsicherheit für geschäftskritisches Tracking gefordert ist. Managed Provider bündeln diese Kosten oft in einer planbaren Gebühr, während Self-Hosted-Setups variable Cloud-Kosten je nach Traffic-Volumen verursachen.
Use Cases und Entscheidungshilfe: Wann lohnt sich Server-Side Tracking?
Nicht jedes Projekt braucht sofort eine vollständige Server-Side-Architektur. Besonders hohen Nutzen bringt der Umstieg, wenn Ad-Blocker einen relevanten Teil Ihrer Conversion-Daten verschlucken, wenn Sie Daten aus mehreren Systemen (CRM, Shop, Analytics) vor der Weitergabe anreichern wollen, oder wenn Checkout-Attribution bislang unvollständig ist, weil Drittanbieter-Skripte im Zahlungsprozess blockiert werden.
Bevor Sie starten, lohnt sich eine kurze Checkliste:
- Wie groß ist der gemessene Datenverlust durch Blocker oder Browser-Restriktionen aktuell?
- Ist das Consent-Management bereits stabil und granular genug, um als Signal zu dienen?
- Steht intern oder extern das technische Know-how für Setup und Betrieb zur Verfügung?
- Rechtfertigt das erwartete Datenvolumen den Aufwand für Infrastruktur und Wartung?
Bei kleinen Websites mit geringem Traffic und wenigen Tracking-Zielen überwiegt der Implementierungsaufwand oft den Nutzen. Hier reicht häufig eine saubere Client-Side-Konfiguration mit konsequentem Consent-Management.
Xpert-Perspektive: Vorgehensweise bei Migrationsprojekten
Bei Migrationsprojekten strukturieren wir die Arbeit in mehreren Phasen: Zunächst ein Assessment, das die aktuelle Datenlage und das Consent-Management bewertet. Danach folgt ein Pilot auf einem begrenzten Teil des Traffics, bevor ein Rollout auf die gesamte Website umgesetzt wird, begleitet von Support für Monitoring und Anpassungen.
Der wichtigste Erfolgsindikator ist für uns nicht die reine Performance-Zahl, sondern die stabile Übertragung des Consent-Signals über den gesamten Trichter. Eine Architektur, die schnell lädt, aber Consent-Status falsch filtert, ist kein Fortschritt. Einblicke in konkrete Projektergebnisse finden sich in unseren Études de cas.
— Xpert
Angebot: Xpert Marketing als Partner für Assessment und Implementierung
Wir begleiten Server-Side-Tracking-Projekte von der ersten Bestandsaufnahme bis zum laufenden Betrieb mit Assessment, technischer Implementierung, Integration der Consent-Signale und fortlaufendem Monitoring.
Für Teams ohne eigenes Entwicklerteam übernehmen wir den technischen Teil, inklusive Domain-Mapping und Testroutinen, damit Sie sich auf die Auswertung der Daten konzentrieren können. Einen Überblick über unser Leistungsspektrum, darunter Data & Analytics und Digital Marketing, finden Sie auf unserer Services-Seite. Nehmen Sie Kontakt auf, um Ihr Projekt zu besprechen.
FAQ
Was unterscheidet Server-Side Tracking von Client-Side Tracking?
Beim Client-Side Tracking sendet der Browser Events direkt an jeden Drittanbieter einzeln. Beim Server-Side Tracking läuft alles zunächst über einen eigenen Servercontainer, der die Weiterleitung steuert. Das verbessert Zustellrate und Kontrolle, ersetzt aber keine Einwilligung.
Ersetzt Server-Side Tracking die Notwendigkeit von Cookie-Consent?
Nein. iubenda stellt klar, dass die Pflicht zur Einholung von Zustimmung unverändert bleibt. Das Consent-Signal muss weiterhin vom Browser über den Webcontainer an den Server durchgereicht werden.
Welche Performance-Vorteile bringt Server-Side Tracking konkret?
Ein reproduzierbarer Benchmark zeigt eine Reduktion des JavaScript-Transfers im Browser um 88,3 Prozent und eine mediane Ladezeitverbesserung von etwa 29,5 Prozent bei konsolidierten Flows. Die Werte stammen aus einem synthetischen Testaufbau und können in Produktionsumgebungen abweichen.
Ist eine Google Analytics Alternative wie Matomo einfacher serverseitig umzusetzen als GA4?
Beide Systeme lassen sich serverseitig anbinden, die technische Architektur mit Webcontainer, Servercontainer und Consent-Durchleitung bleibt grundsätzlich vergleichbar. Welche Lösung passt, hängt stärker von Datenresidenz-Anforderungen und bestehender Infrastruktur ab als vom Tracking-Modell selbst.
Welche rechtliche Grundlage regelt Server-Side Tracking in der EU?
Maßgeblich sind die EDPB-Leitlinien zum technischen Anwendungsbereich von Art. 5(3) ePrivacy. Sie stellen klar, dass die Vorschrift technikneutral gilt, unabhängig davon, ob Daten zuerst an einen eigenen oder einen externen Server gehen.


